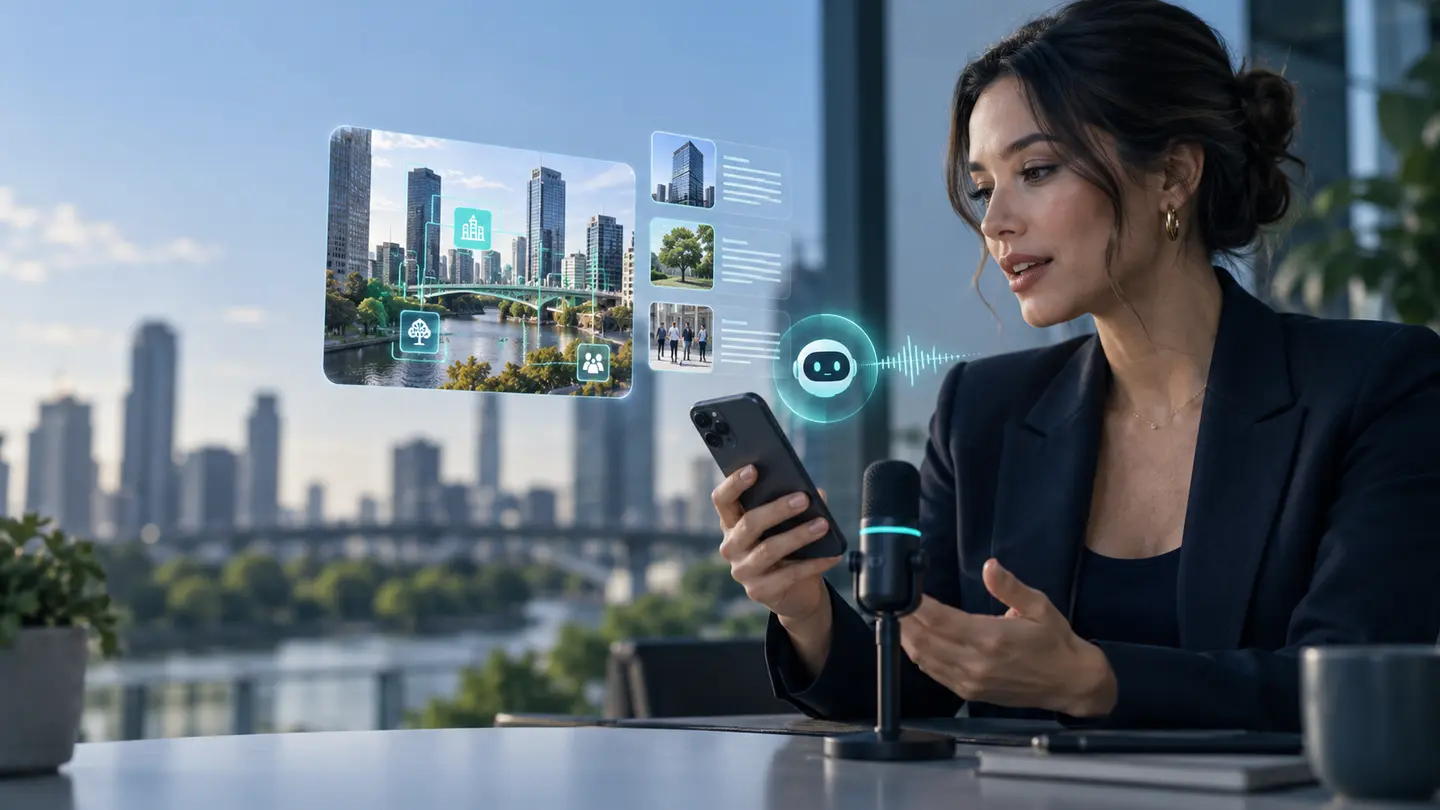
Google ha presentato il 15 settembre Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, due modelli destinati alle interazioni vocali in tempo reale. La promessa non è soltanto parlare con un chatbot: il modello può mantenere il dialogo, interpretare immagini e video, chiamare strumenti e continuare un’attività mentre l’utente resta nella conversazione. È un cambio di interfaccia, non la prova che ogni processo possa essere delegato.
Perché è importante
- Gemini 3.8 Live è pensato per dialoghi vocali a bassa latenza e contesto visivo.
- Extended Thinking può ragionare e parlare mentre completa attività in background.
- La disponibilità varia tra API, Google AI Studio, Search, Workspace e Gemini app.
La voce diventa un’interfaccia per il lavoro
La versione Live punta alla fluidità e alla bassa latenza. La variante Extended Thinking aggiunge ragionamento più profondo e può fornire segnali di avanzamento mentre completa passaggi asincroni. Per chi usa un assistente durante una riunione o un sopralluogo, questo significa poter mostrare una schermata, fare una domanda e ricevere una risposta contestuale senza interrompere ogni volta il flusso. La precisione resta però legata alle fonti e agli strumenti collegati.
Google dichiara supporto per 97 lingue con cambio automatico durante la conversazione e descrive casi come onboarding, troubleshooting e attività guidate dalla voce. Sono capacità del modello e degli ambienti che lo ospitano. Non equivalgono a un’autorizzazione generale a leggere ogni contenuto del telefono, del browser o dell’azienda. Ogni integrazione deve ancora definire quali dati entrano nella sessione e quali azioni possono essere eseguite.
Dove è disponibile e dove no
Per gli sviluppatori, Gemini 3.8 Live è disponibile tramite Gemini API e Google AI Studio, con una scheda tecnica che indica input testuali, immagini, audio e video e output testuale e audio. Per le imprese la distribuzione parte da anteprime private in Gemini Enterprise. Google indica inoltre un rilascio progressivo in Search Live e nelle esperienze Gemini. La parola disponibile va quindi accompagnata dal canale, dal piano e dal Paese.
La documentazione tecnica segnala chiamate di funzione asincrone, streaming audio e ragionamento interleaved. In pratica un’app può chiedere al modello di eseguire un’operazione senza congelare il dialogo, ma deve saper gestire una risposta che arriva dopo. Serve una coda, uno stato leggibile e una regola per interrompere il lavoro. Senza questi elementi, la conversazione naturale può mascherare un processo che non ha mai raggiunto il risultato.
La disponibilità graduale vale anche per le funzioni dentro Workspace, Search e Gemini app. Una demo vista online non certifica che lo stesso menu sia attivo sul proprio account. Prima di annunciare un nuovo servizio è quindi necessario verificare modello, regione, lingua, quota, diritti sui dati e possibilità di esportare un log dell’azione.
Cosa puoi farci concretamente
- Separare conversazione, chiamata agli strumenti e autorizzazione dell’azione.
- Provare un flusso innocuo con dati fittizi prima di collegare account reali.
- Misurare latenza, errori, interruzioni e costo per attività completata.
Tre casi d’uso utili senza consegnare tutto all’agente
Il primo caso è l’assistenza guidata: una persona mostra un errore sullo schermo e l’AI propone controlli ordinati, chiedendo conferma prima di modificare impostazioni. Il secondo è l’onboarding: il nuovo collega pone domande a voce mentre l’agente consulta soltanto documenti approvati. Il terzo è la raccolta di informazioni sul campo, con dettatura e classificazione preliminare che restano da rivedere.
In tutti e tre i casi l’AI produce valore quando il perimetro è stretto. Una guida tecnica può autorizzare lettura di una knowledge base, ma non la modifica delle policy. Un agente commerciale può preparare una scheda, ma non inviare un’offerta senza controllo. La voce accelera l’accesso al processo; non sostituisce la definizione di chi può approvare, correggere o annullare.
La prova più utile non è chiedere una risposta brillante. È misurare quante volte l’utente deve ripetere la richiesta, quante azioni vengono interrotte, quali fonti vengono citate e quanto tempo serve per correggere un errore. Un flusso vocale può sembrare naturale e restituire comunque un dato sbagliato con grande sicurezza.
Privacy, latenza e controllo delle azioni
Il microfono aperto cambia la superficie dei dati. Prima di collegare una funzione vocale bisogna descrivere quando inizia la sessione, quali audio vengono conservati, chi può ascoltare la trascrizione e come si chiude il contesto. Google dichiara watermark SynthID per l’audio generato dai suoi prodotti, utile per la provenienza dell’output, ma il watermark non risolve da solo autorizzazioni, conservazione e accesso alle registrazioni.
La latenza è un requisito operativo. Una risposta vocale quasi immediata può essere adatta a una guida; un’azione che dipende da tre API deve mostrare che è ancora in corso. L’interfaccia dovrebbe distinguere ascolto, ragionamento, chiamata allo strumento, risultato e errore. Senza stati visibili l’utente può credere che l’agente abbia completato una prenotazione, una modifica o un invio quando ha soltanto preparato una proposta.
Gemini 3.8 Live rende più naturale il passaggio tra parlare e fare, ma la parte difficile resta progettare il confine. Parti da un compito reversibile, usa account di test e conserva l’evidenza dell’esito. Solo dopo avere misurato qualità, costi e fallimenti ha senso estendere la voce a clienti, dati personali o processi che non possono essere annullati.
Fonti
Documenti, comunicati e pubblicazioni consultati per ricostruire dati e contesto.